
30. Okt. 2026
Autonome Systeme testen, wo die Realität an Grenzen stößt
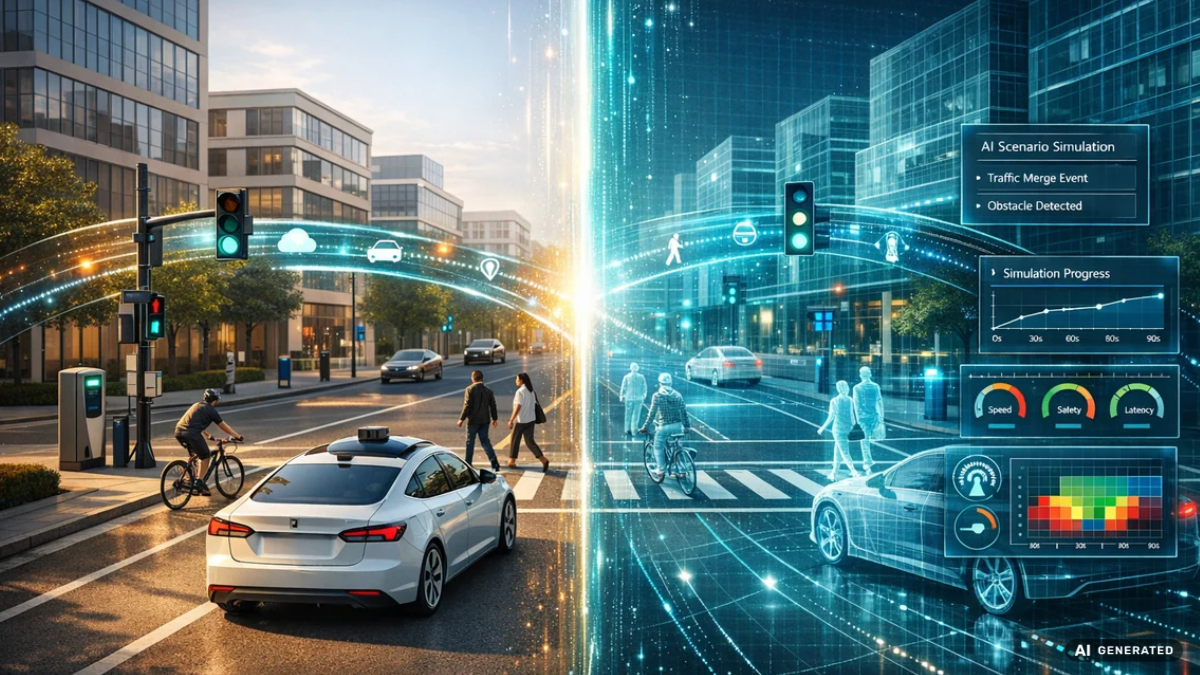
Wie Simulation und generative KI zusammenwirken
Autonome Systeme müssen in der Realität funktionieren – zuverlässig, auch dann, wenn etwas Unerwartetes passiert. Ein Mensch tritt unvermittelt in den Arbeitsbereich eines Roboterarms. Ein Sensor wird durch tiefstehende Sonne geblendet. Ein Bauteil verhält sich anders als erwartet.
Genau diese seltenen Momente entscheiden später über Sicherheit, Zuverlässigkeit und Akzeptanz. Das Problem: In der realen Welt lassen sich solche Situationen kaum gezielt herstellen, kaum wiederholen und oft nur mit erheblichem Risiko oder Aufwand beobachten. Simulationen schließen diese Lücke – als Testfeld, als Entwicklungsbeschleuniger und als Quelle für Trainingsdaten, die in der Realität schwer zu erhalten sind.
01 — Beobachtung
Warum die reale Welt kein guter Trainingsplatz ist
Ob Fertigungsroboter, fahrerlose Transportsysteme, OP-Assistenzsysteme oder Inspektionsdrohnen in der Energieinfrastruktur: Autonome Systeme treffen Entscheidungen auf Basis dessen, was sie in Entwicklung und Training gesehen haben. Genau hier liegt das Problem. Der reale Betrieb liefert vor allem Normalfälle. Die Situationen, die über Sicherheit entscheiden, sind selten: ungewöhnliche Lichtverhältnisse, seltene Objektklassen, Sensorausfälle, Wetterextreme, menschliches Fehlverhalten in der Nähe der Maschine.
Diese seltenen Fälle gezielt in der Realität zu erzeugen, ist in der Regel keine Option. Man provoziert keinen Beinahe-Unfall, um Trainingsdaten zu sammeln. Man wartet nicht monatelang auf den einen Wetterzustand, der ein Kamerasystem an seine Grenzen bringt. Die Konsequenz: Reale Daten bilden häufig genau die Fälle nicht ab, auf die es am meisten ankommt.
02 — Testfeld
Simulation als Testfeld für das Unwahrscheinliche
Simulierte Umgebungen drehen dieses Problem um. Statt auf den seltenen Fall zu warten, wird er gezielt konstruiert – beliebig oft, unter kontrollierten Bedingungen, ohne Risiko für Menschen oder Maschinen. Lichtverhältnisse, Hindernisse, Materialeigenschaften, Sensorrauschen oder Bewegungsabläufe lassen sich systematisch variieren und in Kombinationen testen, die im realen Betrieb über Jahre nicht zusammentreffen würden.
Jeder Simulationslauf ist zudem exakt reproduzierbar. Was in einem Testlauf passiert ist, lässt sich im Detail rekonstruieren – welche Parameter galten, welche Entscheidung das System getroffen hat, warum. Gerade in regulierten Umgebungen wie Medizintechnik, Energiewirtschaft oder Defense ist das mehr als ein Komfortgewinn: Es ist die Grundlage für eine belastbare Nachweisführung. Man zeigt nicht nur, dass ein System in der Praxis bisher gut funktioniert hat. Man zeigt, wie es sich in genau definierten, auch kritischen Situationen verhält.
03 — Beschleunigung
Simulation als Entwicklungsbeschleuniger
Neben der Sicherheit geht es um Geschwindigkeit. Physische Prototypen, Testaufbauten und Feldversuche sind teuer und langsam – besonders im Maschinen- und Anlagenbau und in der Robotik, wo jede Iteration Hardware, Aufbauzeit und oft auch Stillstand realer Anlagen bedeutet. Simulation erlaubt, Entwurfsentscheidungen zu testen, bevor überhaupt etwas gebaut wird.
Entscheidend ist dabei auch die Parallelisierung: Statt eines Testfahrzeugs, das nacheinander Szenarien abfährt, lassen sich zahlreiche Simulationsläufe gleichzeitig durchführen. Was früher Monate an Felderprobung brauchte, lässt sich in der Simulation in einem Bruchteil der Zeit durchspielen. Das verändert, wie früh im Entwicklungsprozess belastbare Aussagen über Verhalten, Robustheit und Grenzen eines Systems möglich sind – lange bevor die erste reale Testfahrt oder der erste reale Einsatz stattfindet.
04 — Datengrundlage
Synthetische Trainingsdaten aus der Simulation
Ein oft unterschätzter Nutzen von Simulation liegt nicht im Testen, sondern im Erzeugen von Trainingsdaten für die Wahrnehmungskomponenten autonomer Systeme – insbesondere für Computer-Vision-Modelle, die Objekte erkennen, Entfernungen schätzen oder Situationen klassifizieren. Simulierte Sensordaten, etwa Kamerabilder oder Tiefeninformationen, lassen sich mit exakten Ground-Truth-Informationen erzeugen: Die Simulation „weiß“, wo sich ein Objekt tatsächlich befindet, welche Klasse es hat, wie groß es ist. Aufwendige manuelle Annotation entfällt an dieser Stelle weitgehend.
Hier lohnt eine begriffliche Unterscheidung: Eine Simulation approximiert die Realität und das Verhalten der darin handelnden Akteure auf Basis expliziter Modelle – von Umgebung, Sensorik, Physik oder Bewegungsabläufen. Wie nah diese Approximation an der Realität liegt, hängt davon ab, wie detailliert und zutreffend die zugrunde liegenden Modelle und Annahmen sind; automatisch physikalisch akkurat ist eine Simulation damit nicht. Generative KI folgt einer anderen Logik: Sie approximiert Plausibilität auf Basis gelernter Muster aus Daten, ohne dass ihr ein explizites Modell der Welt zugrunde liegt. Statt die beiden Ansätze als Alternativen zu betrachten, lohnt sich ein Blick auf ihr Zusammenspiel: Generative Verfahren lassen sich gezielt einsetzen, um simulierte Daten im Nachgang realistischer oder informativer zu machen – etwa indem Texturen, Materialoberflächen oder Sensorcharakteristika angereichert werden, um sie näher an reale Aufnahmen zu bringen. Die durch explizite Modellierung erzeugte Struktur der Simulation bleibt dabei erhalten, während generative KI gezielt dort nachschärft, wo die Modellierung an ihre Grenzen stößt oder zu grobe Vereinfachungen vornimmt.
Kontext
Forschung zu robuster Wahrnehmung
In mehreren Forschungsprojekten – darunter VALISENS, ENGEL, COSMOS, SASKKIA und ReSimCAV – untersuchen wir gemeinsam mit Partnern aus Industrie und Forschung, wie sich Wahrnehmungskomponenten autonomer Systeme robuster gestalten lassen. Im Mittelpunkt steht die Frage, wie Modelle zuverlässiger werden gegenüber genau den Bedingungen, die in realen Datensätzen kaum vorkommen: seltene Objektklassen, ungünstige Witterung oder sensorische Störungen. Drei Erkenntnisse aus unserer Forschung zeigen, wie Simulation und generative KI dabei konkret ansetzen:
Gezielte Datenanreicherung statt vollständiger Neugenerierung: Beim Training von Segmentierungsmodellen für seltene Objektklassen führt eine vollständig synthetische Bildgenerierung häufig zu Abweichungen zwischen Bildinhalt und Label. Unser Ansatz erhält deshalb die für die Erkennung kritischen Bildbereiche unverändert und reichert nur den umgebenden Kontext an – so entsteht visuelle Vielfalt, ohne die Zuverlässigkeit der Labels zu gefährden. (arxiv.org/pdf/2606.31603)
Ähnlichkeit ist nicht gleich Nutzen: Optisch überzeugende synthetische Daten führen nicht automatisch zu besserer Erkennungsleistung. Unsere Untersuchungen zeigen: Entscheidend ist nicht, wie ähnlich ein generiertes Bild einem realen Bild erscheint, sondern wie gut ein Wahrnehmungsmodell die enthaltenen Merkmale tatsächlich nutzen kann. Synthetische Daten sollten deshalb konsequent danach bewertet werden, was sie für die eigentliche Aufgabe leisten – nicht danach, wie „echt“ sie aussehen. (arxiv.org/pdf/2609.18100)
Simulation zur Absicherung im laufenden Betrieb: Neben der Datengenerierung nutzen wir Simulation auch, um Systemverhalten gegenüber unvorhergesehenen Störungen abzusichern – etwa dem Ausfall eines Sensors. So lässt sich untersuchen, wie ein System solche Störungen im laufenden Betrieb selbstständig erkennen und ausgleichen kann. (arxiv.org/pdf/2504.20477, arxiv.org/pdf/2601.13732)
05 — Risiko
Die Realitätslücke: Wo Simulation an ihre Grenzen stößt
Eine Simulation ist ein Modell der Realität – kein Abbild davon. Sensorcharakteristika, Materialverhalten, Lichtphysik oder Reibungseffekte werden angenähert, nicht exakt reproduziert. Modelle, die ausschließlich auf simulierten Daten trainiert wurden, können in der Simulation hervorragend funktionieren und in der Realität trotzdem versagen. Dieses Phänomen ist als „Sim-to-Real Gap“ bekannt und bleibt eine der zentralen Herausforderungen beim Einsatz synthetischer Daten.
An genau dieser Stelle setzt der gezielte Einsatz generativer KI an. Statt simulierte Daten unverändert zu verwenden, lassen sich die typischen Schwächen der Simulation – zu klare Texturen, zu wenig Sensorrauschen, zu „perfekte“ Oberflächen – gezielt durch generative Verfahren ausgleichen. Damit rücken simulierte Daten näher an die Verteilung realer Aufnahmen heran, ohne dass dafür reale Daten in entsprechender Menge gesammelt werden müssten. Das verringert die Sim-to-Real Gap, beseitigt sie jedoch nicht vollständig: Generative Modelle lernen aus vorhandenen Beispielen und können ihrerseits Verzerrungen einführen, wenn die zugrunde liegenden Trainingsdaten selbst nicht repräsentativ sind.
Ein zweites, grundsätzlicheres Problem bleibt davon unberührt: Eine Simulation kann nur das abbilden, was in ihr modelliert wurde. Seltene, aber bekannte Szenarien lassen sich gezielt erzeugen und auch realistischer gestalten. Szenarien, an die bei der Modellierung schlicht niemand gedacht hat, bleiben unsichtbar – mit ihnen auch die Schwächen, die ein System in der Realität zeigen könnte. Wer sich ausschließlich auf bestandene Simulationstests verlässt, läuft Gefahr, eine Scheinsicherheit zu gewinnen: Das System hat gezeigt, dass es das Modell der Welt meistert. Nicht automatisch, dass es die Welt selbst meistert.
06 — Einordnung
Was Simulation leisten kann – und was nicht
Simulation ersetzt reale Validierung nicht, sie ergänzt sie – auch dann, wenn generative KI eingesetzt wird, um die Lücke zwischen simulierten und realen Daten zu verkleinern. Ihr Wert liegt in der Breite, Kontrolle und Wiederholbarkeit, mit der sich seltene und kritische Fälle untersuchen lassen – etwas, das in der Realität kaum systematisch möglich ist. Reale Tests behalten trotzdem eine unverzichtbare Funktion: Sie zeigen, ob die Annahmen hinter der Simulation, und auch die Annahmen hinter jeder nachträglichen Verbesserung durch generative Verfahren, tatsächlich zutreffen.
In der Praxis bewährt sich deshalb ein mehrstufiges Zusammenspiel: Simulation für Skalierung und gezielte Szenarienerstellung, generative Verfahren zur gezielten Annäherung an reale Datenverteilungen, und reale Tests für Kalibrierung, Validierung und den finalen Nachweis. Entscheidend ist außerdem, wer festlegt, welche Szenarien in der Simulation überhaupt relevant sind und an welchen Stellen generative Anreicherung tatsächlich einen Mehrwert bringt. Das ist keine rein technische Aufgabe – sie erfordert Fachwissen über die tatsächlichen Einsatzbedingungen, die Risiken und die Grenzfälle, die im jeweiligen Anwendungsfeld wirklich zählen.
Fazit
Simulation verändert, wie autonome Systeme entwickelt werden: Sie macht seltene und kritische Situationen testbar, beschleunigt Entwicklungszyklen erheblich und liefert Trainingsdaten in einer Breite, die reale Datenerfassung allein kaum leisten kann. Generative KI erweitert diesen Ansatz, indem sie simulierte Daten gezielt realistischer und relevanter für das Training macht – und so eine der zentralen Limitierungen der Simulation adressiert, ohne sie vollständig aufzulösen.
Der Mehrwert entsteht nicht durch Simulation oder generative KI allein, sondern durch den bewussten Umgang mit den Grenzen beider Ansätze: durch ihre durchdachte Kombination mit realer Validierung, durch kritisches Hinterfragen der eigenen Modellannahmen und durch Fachwissen darüber, welche Szenarien tatsächlich entscheidend sind. Die Frage ist nicht, ob Simulation und generative KI in der Entwicklung autonomer Systeme eine Rolle spielen. Die Frage ist, wie durchdacht ihr Zusammenspiel gestaltet wird.
Ausblick
Simulation über die Entwicklung hinaus
Die hier beschriebenen Einsatzfelder von Simulation betreffen vor allem die Entwicklungsphase autonomer Systeme: das gezielte Konstruieren seltener und kritischer Szenarien zum Testen und zur Erzeugung von Trainingsdaten sowie die generelle Beschleunigung von Entwicklungsiterationen.
Ein eng verwandtes und zunehmend relevantes Thema ist der Einsatz von Simulation über den gesamten Lebenszyklus eines Systems hinweg: der Digital Twin, ein fortlaufend mit realen Betriebsdaten abgeglichenes virtuelles Abbild eines realen Systems. Während es im Entwicklungskontext vor allem um das Vorbereiten auf die Realität geht, geht es beim Digital Twin um das kontinuierliche Verständnis und die Weiterentwicklung eines Systems während es bereits im realen Einsatz ist. Diesem Thema und seinen eigenen Chancen und Herausforderungen widmen wir uns in einem zukünftigen Artikel.